Beim Elektrizitätswerk Nidwalden EWN waren EDR, Firewall und Privileged Access Management im Einsatz. Es fehlte jedoch die Gesamtsicht: Die Logs lagen getrennt in den jeweiligen Herstellerökosystemen, im Defender-Umfeld nur 30 Tage weit zurück. Deshalb haben wir eine Lösung gebaut, die den Netzwerkverkehr in Echtzeit überwacht, die Logs aller Quellen herstellerunabhängig vor Ort aufbewahrt und wichtige Alerts ins Security Operations Center weiterleitet. Damit ist die Grundlage für eine forensische Analyse geschaffen, und dieser Beitrag zeigt, warum wir uns dabei gegen den naheliegenden Weg über Microsoft Sentinel entschieden haben.
Die Inhalte dieses Beitrags stammen aus unserem Live-Webinar vom September 2026. Hier geht's zur Webinar-Aufzeichnung auf unserem YouTube-Kanal.
Die Ausgangslage beim EWN
Das Elektrizitätswerk Nidwalden ist ein kantonales Energieversorgungsunternehmen mit 128 Mitarbeitenden, acht eigenen Wasserkraftwerken und einem Stromabsatz von 298.18 Millionen Kilowattstunden im Jahr 2025. Als Betreiber kritischer Infrastruktur hat das EWN einen entsprechend hohen Schutzbedarf, und die Grundlagen waren vorhanden: Endpoint Detection and Response, eine Firewall, Privileged Access Management für den kontrollierten administrativen Zugriff sowie ein getrenntes IT- und OT-Netz.
Beim Ist-Soll-Vergleich zeigte sich trotzdem eine Lücke. Die Logs des Defender reichten 30 Tage zurück. Die Firewall hatte ihre eigene Aufbewahrungsdauer und ihre eigene Auswertung. Jedes Produkt protokollierte innerhalb seines eigenen Ökosystems: Die Firewall macht Firewall-Logs, der Defender macht Defender-Logs. Was fehlte, war die Sicht über alles hinweg und ein zentraler Ort, an dem die Logs liegen.
Drei Ziele standen am Anfang:
- Die Bereitschaft für eine forensische Analyse verbessern, also nach einem Vorfall weit genug zurückgehen und nachvollziehen können, welche Kommunikation stattgefunden hat und welche Prozesse gestartet wurden
- Logs von Drittquellen anbinden können, um von einzelnen Herstellern und ihren Ökosystemen unabhängiger zu werden
- Die Logs zentral aufbewahren statt verteilt auf mehrere Systeme mit unterschiedlichen Fristen
IST
- Kritische Infrastruktur mit hohem Schutzbedarf
- EDR, Firewall und PAM sind im Einsatz
- Getrennte OT- und IT-Netzwerke
- Defender-Logs reichen 30 Tage zurück
- Jedes Produkt protokolliert im eigenen Ökosystem
SOLL
- Logs von Drittquellen anbinden
- Bereitschaft für Forensik verbessern
- Logs zentral aufbewahren
- Sicht über alle Systeme hinweg
- Unabhängiger von einzelnen Herstellern
Warum die Logs nicht einfach in die Cloud wandern
Wir sind Microsoft-Partner und setzen die Produkte durchgehend ein. Unsere SOC-Services basieren auf Microsoft Defender, und dieses Ökosystem ist in sich geschlossen: Defender for Endpoint, for Cloud, for Identity und for Office 365 greifen ineinander und liefern eine zusammenhängende Sicht auf Endgeräte, Identitäten und E-Mail.
Sobald aber Logquellen ausserhalb dieser Welt dazukommen sollen, etwa eine Firewall oder Netzwerkdaten, verändert sich das Bild. Diese Daten müssen in die Cloud hinaus, damit sie im gleichen Kontext analysiert werden können. Die Firewall steht im Keller oder im Rechenzentrum, also vor Ort. Bei Microsoft ist der Weg dorthin klar geregelt: Sie setzen vor Ort ein System auf, schicken die Daten dorthin, und von dort gehen sie weiter in die Cloud.
Genau dieses Zwischensystem war der Startpunkt unserer Überlegungen. Wer seine Logs zentral zusammenführen will, kommt an dieser Frage nicht vorbei. Wie Sie die Logquellen innerhalb eines Microsoft-365-Tenants zusammenführen, zeigen wir als Massnahme 7 in unserer M365 Security Checkliste, inklusive der konkreten Klickpfade.
Warum nicht einfach Microsoft Sentinel
Die naheliegende Antwort wäre gewesen, die Daten an Microsoft Sentinel weiterzugeben. Wir haben uns dagegen entschieden, aus zwei Gründen.
Grund 1: Das Kostenmodell
In Sentinel fallen die Kosten grundsätzlich nach Datenmenge an. Das ist in der Cloud üblich: Je mehr Ressourcen Sie beziehen, desto höher die Rechnung. Es gibt zwei Preisstufen. Die erste kostet 5 Franken pro Gigabyte und enthält 90 Tage Aufbewahrung. In dieser Stufe können Sie beliebig durchsuchen und analysieren. Die zweite Stufe kostet 15 Rappen pro Gigabyte, dort wird aber jede Abfrage separat verrechnet.
| Preisstufe | Preis pro Gigabyte | Aufbewahrung | Abfragen |
|---|---|---|---|
| Erste Stufe | 5 Franken | 90 Tage inbegriffen | inbegriffen |
| Zweite Stufe | 15 Rappen | je nach Konfiguration | je Abfrage verrechnet |
Zum reinen Speichern ist die günstigere Stufe attraktiv. Sobald Sie ein paar Abfragen machen, kommt die Rechnung im Nachhinein. Eine Schätzung abzugeben ist schwierig: Es gibt Monate ohne eine einzige Abfrage und Monate, in denen laufend etwas nachgeschaut wird.
Grund 2: Der Funktionsumfang
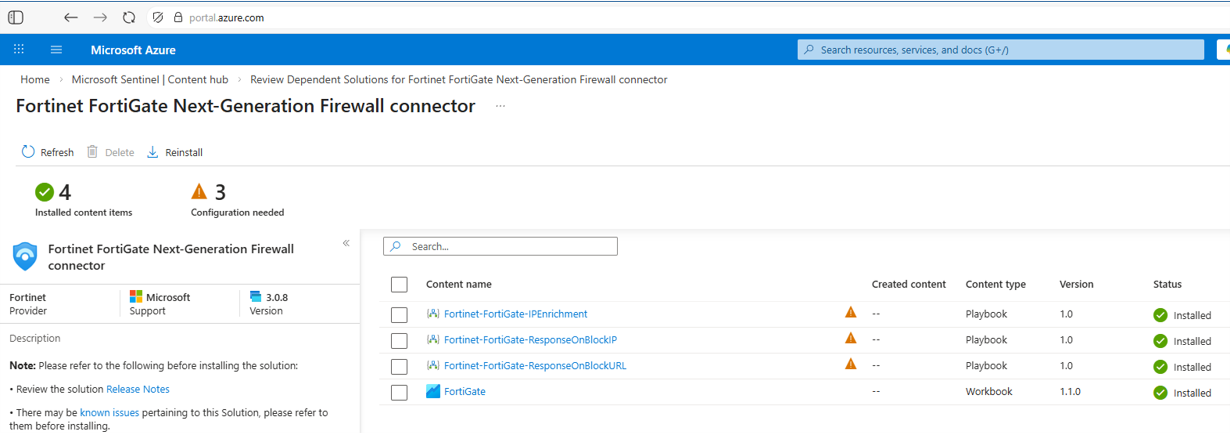
Damit Firewall-Daten in Sentinel ankommen, braucht es einen Connector. Er übersetzt die Firewall-Logs in die Sprache von Defender und Sentinel, damit alles im gleichen Format vorliegt. Der Standard-Connector für FortiGate bringt ein Workbook und drei Playbooks mit. Das Workbook ist eine grafische Auswertung, im Wesentlichen ein Mengengerüst: wie viel Traffic war unterwegs. Die Playbooks ermöglichen einen Eingriff, mitgeliefert wird zum Beispiel das Blockieren einer IP-Adresse.
| Element | Typ | Funktion |
|---|---|---|
| FortiGate | Workbook | Grafische Auswertung des Traffic-Mengengerüsts |
| Fortinet-FortiGate-IPEnrichment | Playbook | Anreicherung von IP-Adressen mit Zusatzinformationen |
| Fortinet-FortiGate-ResponseOnBlockIP | Playbook | Blockieren einer IP-Adresse |
| Fortinet-FortiGate-ResponseOnBlockURL | Playbook | Blockieren einer URL |
Mehr ist nicht enthalten. Weitere Sicherheitsanalysen sind keine dabei. Salopp gesagt haben Sie für die 5 Franken pro Gigabyte Ihre Daten in der Cloud und sonst noch nichts. Das war für uns der Punkt, an dem wir uns nach Alternativen umgeschaut haben.
Das Rechenbeispiel
Beim EWN analysieren wir rund 2 Terabyte Netzwerkverkehr pro Tag. Das entspricht etwa vier randvollen iPhones mit Ferienfotos, und zwar täglich. Aus diesen 2 Terabyte Traffic fallen etwa 50 Gigabyte Logs an, also die Information, wer wann mit wem kommuniziert hat.
| Analysierter Netzwerkverkehr | rund 2 Terabyte pro Tag |
|---|---|
| Daraus entstehende Logs | rund 50 Gigabyte pro Tag |
| Empfohlene Aufbewahrung | 90 Tage |
| Preis pro Gigabyte | 5 Franken |
| Kosten für 90 Tage | rund 22'500 Franken |
Danach liegen die Logs in der Cloud. Ausgewertet ist damit noch nichts.
Die Frage, die unser Design bestimmt hat
Wenn ohnehin ein System vor Ort stehen muss, um die Daten weiterzureichen, warum geben wir ihm nicht eine Oberfläche und zusätzliche Aufgaben? Warum sollen die Daten lokal nicht durchsuch- und filterbar sein, wenn sie sowieso durch dieses System laufen?
Das hat zwei praktische Vorteile. Erstens lässt sich ein System, das im Alltag Nutzen bringt, intern besser begründen als eines, das ausschliesslich Logs für schwere Zeiten sammelt. Zweitens haben Sie im Ernstfall den handwerklichen Teil bereits im Griff. Sie fangen nicht damit an, ein System zu bedienen, das vor einem Jahr aufgesetzt wurde und bei dem dann ein Update fehlt oder eine Funktion nicht mehr läuft.
Vier Anforderungen haben wir daraus abgeleitet:
-
Echtzeitanalyse
Sehen, was jetzt gerade läuft, statt nur im Rückblick.
-
Historische Analyse
In der Zeit zurückgehen und nachvollziehen, was genau passiert ist.
-
Beliebige Quellen anbinden
Ein neues Tool oder eine neue Applikation lässt sich integrieren.
-
Zusätzliche Sicherheitschecks
Eine Zweit- oder Drittmeinung dazu, was im Netzwerk läuft und ob das so sein muss.
Die Lösung, die daraus entstanden ist, stützt sich auf zwei Werkzeuge. Das eine hat den Schwerpunkt auf der Echtzeitanalyse, das zweite auf der Historisierung. Von dort lassen sich die Logs weiterhin in die Cloud übergeben, wo das sinnvoll ist.
Die Architektur: eine Kopie statt eines Eingriffs
Wir schicken eine Kopie des Netzwerkverkehrs an die Sensoren. Der Weg dafür ist der SPAN-Port, also eine Switch-Konfiguration, die den Verkehr auf eine zusätzliche Schnittstelle spiegelt. Die Sensoren lassen sich verteilt aufsetzen, womit mehrere Standorte abgedeckt sind: ein zweites Rechenzentrum für die Ausfallsicherheit oder eine Zone, in der Services wieder hochgefahren werden können.
Der Unterschied zur Firewall ist zentral. Eine Firewall greift immer direkt in die Kommunikation ein. Wenn Sie ihr zu viele Prüfungen aufbürden, merken Sie das irgendwann an langsameren Verbindungen. Wir arbeiten auf einer Kopie, entsprechend spielt die Geschwindigkeit keine Rolle. Wir können so viele Auswertungen fahren, wie wir wollen, im Alltag merkt das niemand.
Die Sensoren selbst sind vollständig passiv. Sie nehmen den gespiegelten Verkehr entgegen, senden nichts zurück und lassen sich nicht dediziert ansprechen. Die Angriffsfläche eines solchen Sensors ist damit sehr klein.
Diese Bausteine sind heute unter dem Namen Managed Protected Network Teil unseres Service-Angebots. Warum wir Sicherheit grundsätzlich als fortlaufenden Prozess und nicht als Produktkauf verstehen, habe ich im Beitrag «Zero Trust ist ein Etikettenschwindel» ausgeführt.
Was die Lösung im Alltag zeigt
Echtzeitansicht des eigenen Netzwerks
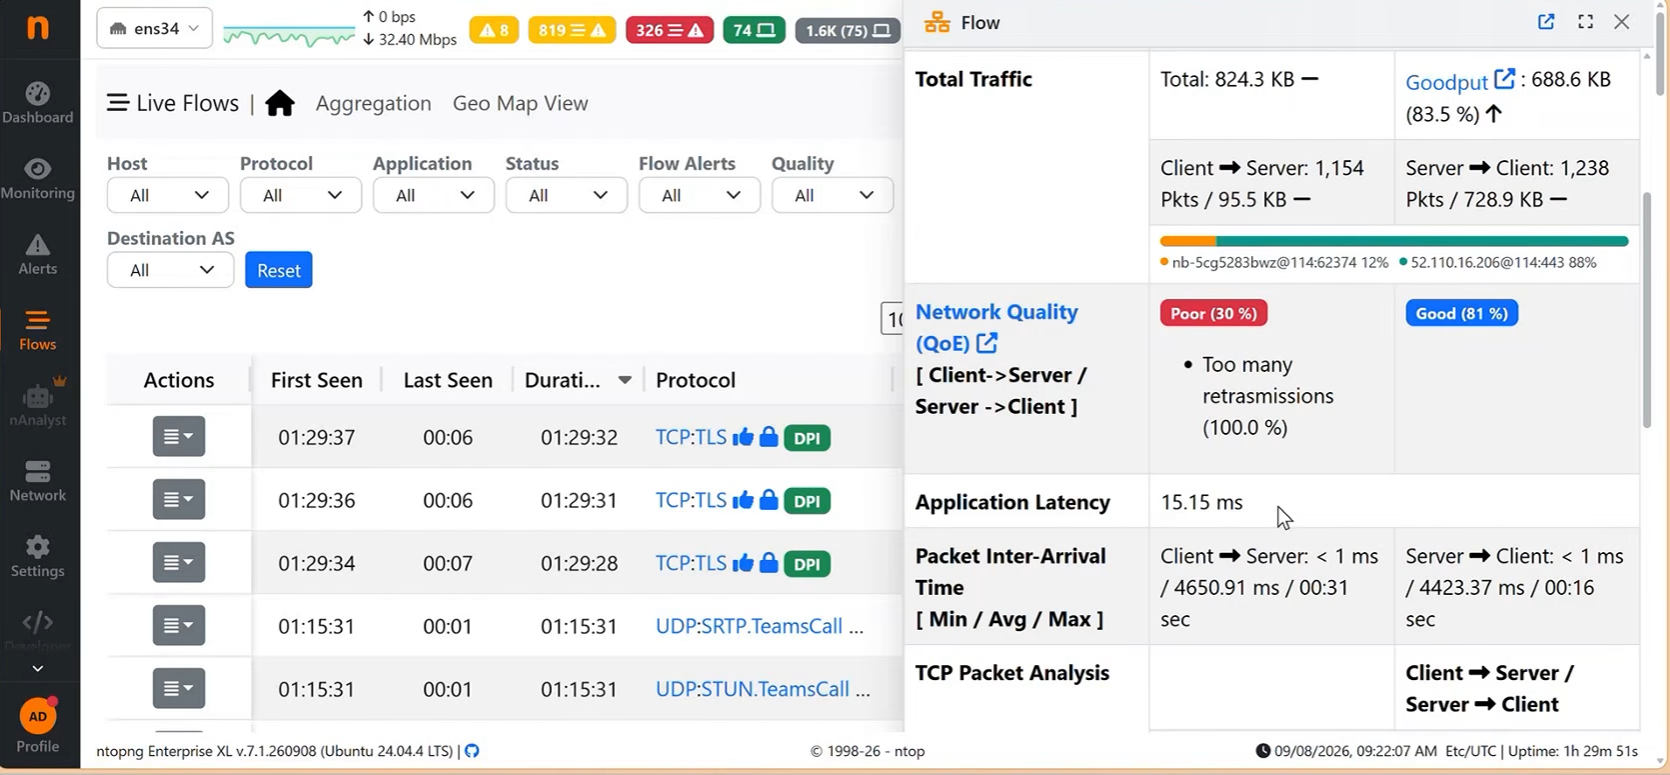
Die Ansicht zeigt die Datenmengen, die durchgehen, und vor allem die Flows. Ein Flow ist die gesamte Kommunikation zwischen zwei Geräten, so wie wir uns ein Gespräch vorstellen. Das ist der Unterschied zu einer Liste einzelner Pakete: Wer nur einzelne Wörter hört, versteht nicht, worum es geht.
Filtern Sie auf ein einzelnes Gerät, sehen Sie alle offenen Verbindungen, etwa einen laufenden Teams-Call. Zu jeder Verbindung sehen Sie, wie lange sie offen ist, wie viel Verkehr in welche Richtung läuft und wie die Qualität aussieht. Eine schlechte Verbindung fällt sofort auf, weil das Gerät zu viele Retransmissions macht, sinngemäss also sagt: «Diesen Teil habe ich nicht verstanden, schick ihn nochmals.» Die Latenz lag in unserem Beispiel bei 15 Millisekunden, das ist unauffällig. Damit ist klar, dass die Verzögerung nicht die Ursache ist, sondern etwas anderes im Netzwerk.
Historische Auswertung
Für die Rückschau stehen verschiedene Dashboards bereit. Ein Beispiel aus unserer eigenen Umgebung ist NTLM. Microsoft hat dieses Authentifizierungsprotokoll abgekündigt, es wird künftig deaktiviert. Die Frage lautet also: Nutzen wir das intern noch, und müssen wir aktiv werden?
Über die letzten 24 Stunden gefiltert wurde sichtbar, dass mehrere interne Systeme weiterhin per NTLM mit einem bestimmten Server sprechen. Wenn Microsoft das Protokoll abschaltet, wäre dieser Server nicht mehr erreichbar. Also bauen wir das vorgängig um. Genau dafür ist diese Sicht gedacht.
Dazu kommt die Integration der Endpoint-Logs. Sie haben damit neben der Netzwerksicht auch die Prozessdaten der Geräte am selben Ort. Wenn Sie wissen wollen, wann sich ein bestimmtes Gerät wohin verbunden hat, gehen Sie so weit zurück, wie Daten gespeichert sind.
Alerts als zweite Meinung
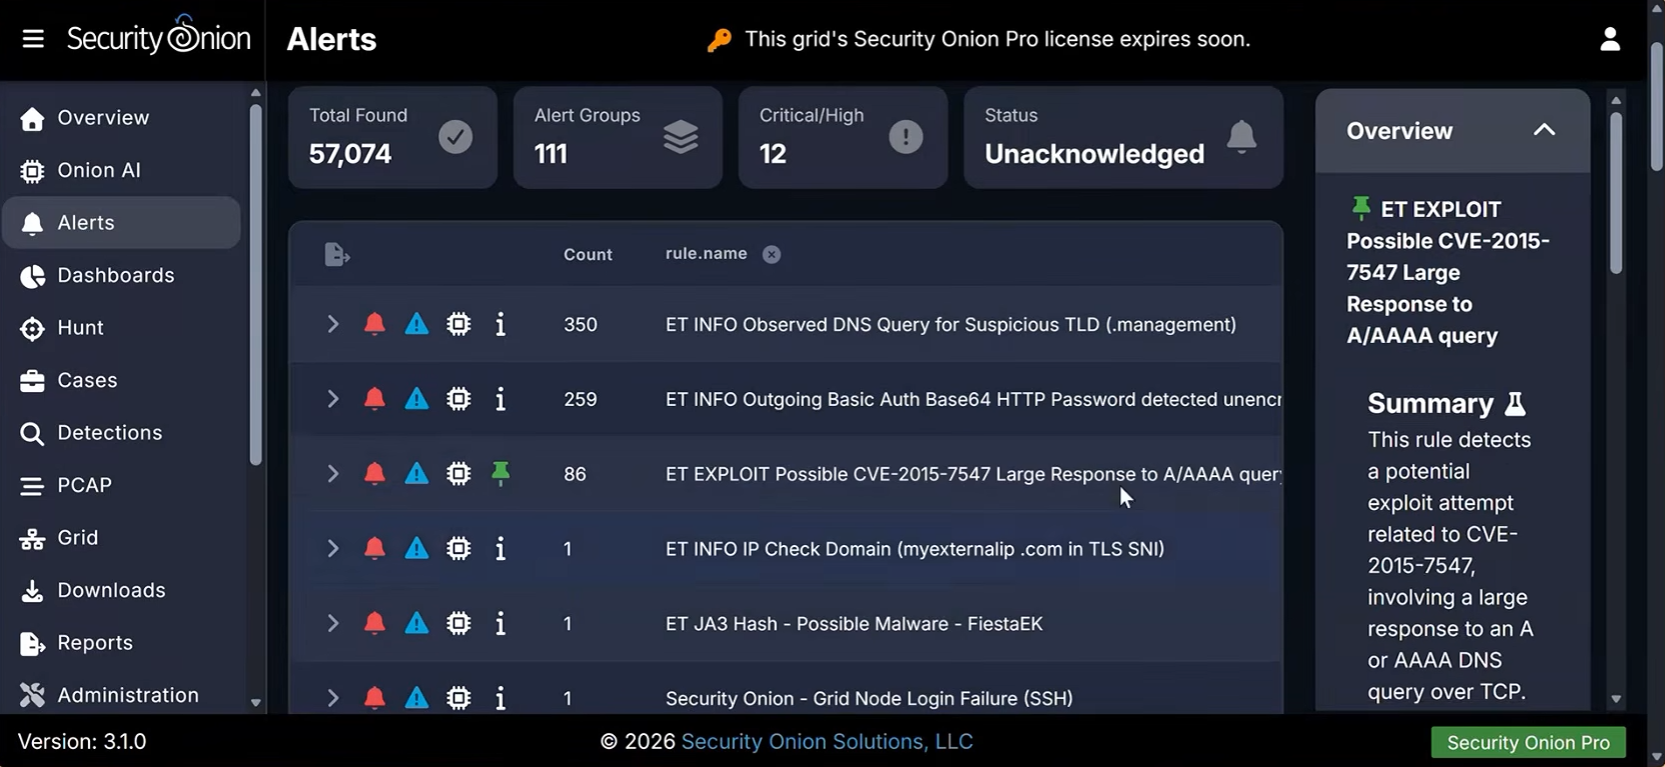
Auf den ersten Blick wirkt das erschlagend: In den letzten 24 Stunden waren rund 57'000 Alerts aufgelaufen. Wer soll das bewirtschaften?
Es sieht schlimmer aus, als es ist. Derselbe Alert erscheint 350 Mal, ein anderer 2'000 Mal. Wer dem nachgeht, aufräumt und filtert, kommt von 57'000 rasch auf eine überschaubare Zahl. Wir machen das im Rahmen des Onboardings als Feintuning, also eine Lernphase über zwei bis drei Monate, in der festgelegt wird, was wir sehen wollen, was nicht und was in dieser Umgebung in Ordnung ist. Danach lassen sich unerwünschte Alerts deaktivieren oder Ausnahmen definieren.
Ein Beispiel aus unserem Lab: Ein System verwendet Basic Auth. Klicken Sie auf den Alert, erscheint zunächst eine CVE-Nummer und der Hinweis «Large Response». Das klingt nach Kauderwelsch. Über die Funktion «Investigate Alert» erstellt eine KI-Analyse daraus einen Investigation Report mit einer Zeitachse, welches Ereignis wann in welchem Log angefallen ist. Ob Basic Auth in Ihrem Microsoft-365-Tenant noch aktiv ist, prüfen Sie übrigens als Massnahme 3 in unserer M365 Security Checkliste.
Vom Alert bis zum einzelnen Paket
Bei einem Alert auf der Firewall ist oft schwer zu beurteilen, ob das so sein muss. Sie sehen, dass eine alte CVE-Nummer ausgenutzt werden soll, und stehen vor einer Einschätzung ohne Grundlage.
Weil wir eine Kopie des Netzwerkverkehrs haben, können wir den gesamten Verkehr hinter einem Alert zwischenspeichern und herunterladen. In unserem DNS-Beispiel war damit im Detail nachvollziehbar: erst der Verbindungsaufbau, dann die DNS-Anfragen, dann eine ungewöhnlich grosse DNS-Antwort mit einer Reihe zufälliger Namen. Damit lässt sich die eigentliche Frage angehen: Um welches Gerät handelt es sich, und warum stellt es diese Anfrage? Das ist der Unterschied zwischen analysieren und raten.
IT und OT getrennt überwachen
Beim EWN gibt es ein IT-Team und ein OT-Team, und diese Trennung besteht auch technisch: je ein eigener Netzwerksensor für die Unternehmens-IT und für die Leitsysteme.
Die OT-Umgebung selbst können wir nicht zeigen. Eine Echtzeitanalyse des Verkehrs macht sehr viel sichtbar, und wir können nicht sicherstellen, dass dabei nichts erscheint, was nicht gezeigt werden darf. Aus dem gleichen Grund haben wir die Demonstration im Webinar in unserem eigenen Lab durchgeführt statt in der Infrastruktur des Kunden.
Die eingesetzten Produkte unterstützen unter anderem folgende OT-Protokolle:
- IEC 60870-5-104, Modbus TCP und Profinet
- BACnet, BSAP, CIP, COTP, DNP3, ECAT, ENIP, OPC UA und S7
Damit lässt sich auf die gleiche Weise auswerten, welche OT-Geräte vorhanden sind und welche davon miteinander sprechen. Weitere Services rund um das Netzwerk finden Sie in unserer Übersicht zu den Network Services.
Das Service-Modell
Wir betreiben die Lösung als Service. Wir setzen das System auf, spielen Updates ein und überwachen, dass alles online ist und funktioniert.
Was im Service enthalten ist:
- Aktives Eingreifen bei kritischen und hohen Alerts. Wir analysieren den Fall und kommen auf Sie zurück, sei es mit einer notwendigen Anpassung einer Einstellung, einer Blockierung auf der Firewall oder der Analyse eines Endgeräts, das kommuniziert, was es nicht soll.
- Wöchentliche Durchsicht der übrigen Alerts. Das meiste davon sind Informationsmeldungen, etwa Kommunikation zu einer bestimmten Top-Level-Domain. Das erfordert keinen sofortigen Eingriff, sollte aber im Griff sein.
- Über 60'000 Erkennungsregeln aus der Community und aus eigener Entwicklung, die wir gegen die Kopie des Verkehrs laufen lassen.
- Monatlicher Report zum Stand und zu den Auffälligkeiten.
- Keine Limitierung der Datenmenge. Sie speichern so viele Daten, wie Sie Platz haben. Beim EWN läuft das auf einer normalen virtuellen Maschine mit zugewiesenem Speicherplatz, bei einem anderen Kunden auf einem älteren Server, der noch verfügbar war.
Wir empfehlen eine Aufbewahrung von mindestens 90 Tagen. Mehr ist besser, 90 Tage sind ein guter Start. Wie unser Security Operations Center im Alltag arbeitet, beantworten wir ausführlich im Beitrag zu den 12 häufigsten Fragen zum SOC. Eine Übersicht über das gesamte Angebot finden Sie bei den Security Services, die Details zum Service im Factsheet Managed Protected Network.
Häufige Fragen
-
Welche Voraussetzungen braucht es für einen SPAN-Port? Sind spezielle Switches nötig?
-
«Speziell» wäre übertrieben. Es braucht einen gemanagten Switch, dann kann er eine Kopie des Netzwerkverkehrs ausleiten. Im Business-Umfeld beherrschen das praktisch alle Switches, es ist eine gängige Standardeinstellung.
-
Was ist der primäre Nutzen: Netzwerkfehler finden, Vorfälle erkennen oder Forensik?
-
Beides. Der Ausgangspunkt war die forensische Bereitschaft, also die Möglichkeit, nach einem Vorfall zurückzuschauen. Daraus entstand die Frage, ob sich dasselbe System auch im Alltag nutzen lässt. Wenn heute jemand meldet, das Internet sei langsam, haben wir eine zusätzliche Analysemöglichkeit.
-
Wie lange dauert die Einführung, und was kostet sie?
-
Wir setzen die Sensoren als virtuelle Maschinen auf. Die Grundvoraussetzung ist, dass der SPAN-Port in die VM gelangt, was in den meisten Fällen einen dedizierten Netzwerkanschluss bedeutet. Das Initial-Setup ist im Normalfall an einem Tag erledigt, abhängig von der Anzahl Sensoren. Danach beginnt die Analyse, und über die folgenden zwei bis drei Monate justieren wir nach. Die Kosten fallen pro Sensor an, die benötigte Anzahl ist eine Architekturfrage. Wir klären sie gerne gemeinsam für Ihre Umgebung.
-
Was passiert, wenn forensisch relevante Daten älter als 90 Tage sind?
-
Wenn keine Daten mehr vorhanden sind, wird es schwierig. Genau deshalb haben wir eine Lösung gewählt, bei der Sie nicht nach Datenmenge bezahlen. Sonst wird jede zusätzliche Quelle und jeder zusätzliche Aufbewahrungstag zu einer Budgetfrage mit Freigabeprozess. So ist es eine Frage des verfügbaren Speicherplatzes: Je mehr Platz Sie entbehren können, desto weiter reichen Ihre Daten zurück.
-
Wir haben bereits ein SIEM im Einsatz. Lässt sich das kombinieren?
-
Ja, in beide Richtungen. Entweder geben Sie die Alerts an Ihr bestehendes SIEM weiter, oder wir integrieren dessen Daten in unsere Lösung. Das ist eine Architekturfrage und zugleich eine Verantwortungsfrage: Wer prüft die Meldungen am Ende?
-
Ist das eine klassische Managed-IDS-Lösung?
-
Wir machen etwas mehr als reines Intrusion Detection, vor allem bei der Sichtbarkeit. Aber «Managed IDS» ist eine zutreffende Einordnung. IDS ist dabei eine Teilkomponente.
Fazit
Was das EWN heute hat, ist in erster Linie eine Grundlage. Die Netzwerkkommunikation ist zentral protokolliert, sie lässt sich über einen längeren Zeitraum zurückverfolgen, und zu einem Alert liegt die zugehörige Kommunikation bis zum einzelnen Paket vor. Genau das war das erklärte Ziel des Projekts. Forensische Bereitschaft ist keine Funktion, die man einschaltet, wenn etwas passiert ist. Sie entsteht vorher oder gar nicht.
Die Entscheidung gegen Microsoft Sentinel war in diesem Projekt keine Entscheidung gegen Microsoft. Wir setzen die Produkte weiterhin durchgehend ein, und für die Defender-Welt ist der Weg richtig. Es war eine Entscheidung gegen ein Kostenmodell, bei dem jede zusätzliche Datenquelle und jeder zusätzliche Aufbewahrungstag eine Budgetfrage auslöst. Wer im Ernstfall zurückschauen können will, sollte diesen Abwägungsentscheid nicht bei jeder Erweiterung neu treffen müssen.
Der zweite Punkt ist mir fast wichtiger: Ein System, das nur Logs für schwere Zeiten sammelt, wird selten bedient und selten gepflegt. Ein System, das im Alltag hilft, Verbindungsprobleme einzugrenzen oder eine Protokollabkündigung wie bei NTLM rechtzeitig zu erkennen, läuft warm. Und wenn es dann tatsächlich ernst wird, steht die Bedienung bereits.
Haben Sie Fragen zur Umsetzung in Ihrer Umgebung? Nehmen Sie Kontakt mit uns auf.